آینده مدیریت داده
آینده مدیریت داده در سازمانها به کدام سمت میرود؟
آینده مدیریت داده (Data Management) دیگر فقط به ذخیرهسازی اطلاعات یا توسعه ابزارهای تحلیلی محدود نیست. سازمانها باید بتوانند دادهها را بهصورت قابل اعتماد کشف، مدیریت و تفسیر کنند و آنها را برای تصمیمگیری و کاربردهای هوش مصنوعی در دسترس قرار دهند.
گزارش «روندهای برتر داده و تحلیل در سال ۲۰۲۶» گارتنر، بر سه محور هوش مصنوعی عاملمحور، پیشرفت در معناشناسی داده و همگرایی سکوهای داده و تحلیل تأکید میکند. این روندها نشان میدهند که آمادگی برای استفاده مؤثر از هوش مصنوعی، تنها به انتخاب مدل مناسب وابسته نیست؛ کیفیت داده، شناخت مفاهیم کسبوکار، یکپارچگی زیرساخت و کنترل نحوه استفاده از اطلاعات نیز اهمیت اساسی دارند.
در کنار این تحولات، رویکردهایی مانند Data Mesh، توسعه کاتالوگهای داده مجهز به هوش مصنوعی و خودکارسازی عملیات زیرساخت داده نیز میتوانند به بهبود دسترسی، قابلیت اطمینان و مقیاسپذیری معماری داده کمک کنند. البته انتخاب هر رویکرد باید متناسب با نیازهای کسبوکار، بلوغ دادهای و الزامات امنیتی سازمان انجام شود.
در ادامه، این تحولات و تأثیر آنها بر تصمیمهای مدیران فناوری اطلاعات و داده را بررسی میکنیم.
۱. Data Mesh در ۲۰۲۶: از ایده به مدل هیبرید
وقتی Zhamak Dehghani در سال ۲۰۱۹ معماری Data Mesh را معرفی کرد، ایده اصلی، حل یکی از مشکلات رایج سازمانهای بزرگ بود: وابستگی بیش از حد ارائه داده به یک تیم مرکزی. اکنون، با گسترش کاربردهای تحلیلی و هوش مصنوعی، مسئله فقط توزیع مسئولیت داده نیست؛ حفظ هماهنگی و قابلیت استفاده از دادهها در سطح کل سازمان نیز اهمیت دارد.
تجربه پیادهسازی Data Mesh نشان میدهد که واگذاری مسئولیت به دامنههای کسبوکار، بهتنهایی برای موفقیت کافی نیست. اگر هر دامنه بدون استانداردهای مشترک، قراردادهای مشخص و زیرساخت مناسب عمل کند، ممکن است ناسازگاری تعاریف، تکرار دادهها و پیچیدگی مدیریت محصولات دادهای افزایش پیدا کند.به همین دلیل، رویکردهای ترکیبی اهمیت بیشتری پیدا کردهاند. در چنین الگویی، Data Mesh مسئولیت و مالکیت داده را به دامنههای کسبوکار نزدیک میکند و Data Fabric میتواند قابلیتهای یکپارچهسازی، کشف و دسترسی به دادهها را تقویت کند. یک پلتفرم مشترک و سازوکار حاکمیت فدرال نیز به حفظ استانداردهای سازمانی کمک میکند. این رویکرد با جهتگیری مطرحشده در بررسی وضعیت Data Mesh در سال ۲۰۲۶ توسط Thoughtworks همراستاست.
در این مدل، دامنههای کسبوکار محصولات دادهای (Data Products) ارائه میکنند که مالک، تعریف، کیفیت، مستندات و شرایط استفاده مشخصی دارند. این محصولات میتوانند در تحلیلهای سازمانی، گزارشگیری و کاربردهای هوش مصنوعی مورد استفاده قرار گیرند. برای مثال، دادههای مشتری که در یک دامنه تولید و مدیریت میشوند، میتوانند با رعایت مجوزهای دسترسی و استانداردهای مشترک، هم در تحلیلهای مدیریتی و هم در مدلهای هوش مصنوعی به کار گرفته شوند.
۲. کاتالوگ داده مجهز به هوش مصنوعی؛ فراتر از فهرست اطلاعات
تا چند سال پیش، کاتالوگ داده یک دایرکتوری بود . ابزاری که تیمهای داده میتوانستند بفهمند «این ستون چه معنایی دارد» یا «این جدول از کجا میآید». در ۲۰۲۶، کاتالوگ داده یک موجودیت کاملاً متفاوت شده است.
کاتالوگداده بهعنوان بستر AI Agents
بزرگترین تحول ۲۰۲۶ این است که کاتالوگ داده دیگر فقط برای انسانها نیست. ایجنتهای هوش مصنوعی برای اجرای وظایف تحلیلی خود باید بدانند کدام داده وجود دارد، کیفیت آن چیست، و چه محدودیتهایی برای استفاده از آن وجود دارد. کاتالوگهای مدرن اکنون:
چالشهای جدید: حاکمیت بر AI Agents
پیشرفت کاتالوگهای هوشمند یک چالش موازی ایجاد کرده است که صنعت آن را Agentic Governance مینامد. وقتی یک AI Agent به دادهها دسترسی دارد و میتواند کوئری بنویسد، خود ایجنت به یک موجودیت نیازمند حاکمیت تبدیل میشود. سازمانها در ۲۰۲۶ باید پاسخ دهند:
این ایجنت به چه دادههایی دسترسی دارد و چرا؟
چه کسی مسئول نتایج تحلیلهای آن است؟
چطور میتوان audit trail عملکرد ایجنت را حفظ کرد؟
برای آشنایی با اجزای فنی و نقش این فناوری در ساختار حاکمیت داده، مقاله معماری فنی کاتالوگ داده (Data Catalog) در خدمت حاکمیت داد را بخوانید.
۳. انبار داده خودران: از اتوماسیون تا خودمدیریتی
انبار داده خودران (Autonomous Data Warehouse) به زیرساختهایی اشاره دارد که بخشی از وظایف عملیاتی و بهینهسازی را بهصورت خودکار انجام میدهند. هدف این فناوریها کاهش کارهای تکراری، بهبود بهرهبرداری از منابع و افزایش توان پاسخگویی به بارهای پردازشی متغیر است.
بسته به محصول، قابلیتها میتوانند شامل تنظیم خودکار منابع پردازشی، بهینهسازی برخی عملیات پایگاه داده، مدیریت خودکار شاخصها و پایش عملکرد باشند.
برای مثال، یک انبار داده ممکن است در زمان افزایش بار کاری منابع بیشتری اختصاص دهد یا با تحلیل الگوی اجرای پرسوجوها، به بهینهسازی عملکرد کمک کند. مستندات رسمی Oracle درباره مقیاسپذیری خودکار پایگاه داده نشان میدهد که این قابلیت در محصولات خودکار این شرکت چگونه پیادهسازی میشود.
بااینحال، خودران بودن به معنی بینیازی کامل از متخصصان داده و پایگاه داده نیست. کنترل هزینه، نظارت بر عملکرد، ارزیابی تغییرات و تعیین محدودیتهای عملیاتی همچنان اهمیت دارند. همچنین باید میان قابلیتهای واقعی محصول و مفهوم گستردهتر «انبار داده کاملاً خودران» تفاوت قائل شد؛ همه محصولات تمام وظایف را خودکار نمیکنند.
ارزش این تحول زمانی مشخص میشود که سازمان بتواند با حفظ کیفیت خدمات و کنترل هزینه، زمان تیم فنی را از نگهداریهای تکراری به توسعه قابلیتهای ارزشآفرین اختصاص دهد.
۴. داده آماده برای هوش مصنوعی؛ اهمیت زمینه معنایی
یکی از جهتگیریهای مهم مدیریت داده در سال ۲۰۲۶، فراهم کردن زمینه قابل اعتماد برای سامانههای هوش مصنوعی است. این سامانهها برای ارائه پاسخ معتبر باید علاوه بر دسترسی به داده، معنای مفاهیم سازمانی و ارتباط میان اطلاعات را نیز درک کنند.
گارتنر در گزارش ۱۱ مه ۲۰۲۶ درباره نقش معناشناسی در دقت عاملهای هوش مصنوعی هشدار میدهد که نبود زمینه معنایی میتواند به پاسخهای نادقیق، افزایش هزینه و تشدید ریسکهای حاکمیت داده منجر شود.
این مسئله در سازمانهای بزرگ اهمیت ویژهای دارد. ممکن است یک شاخص در دو سامانه تعریف متفاوتی داشته باشد یا اطلاعات مورد استفاده در یک تحلیل، از منبعی قدیمی استخراج شده باشد. در چنین شرایطی، حتی پیشرفتهترین مدل هوش مصنوعی نیز لزوماً به نتیجه قابل اتکا نمیرسد.
برای آمادگی بهتر زیرساخت داده، سازمانها باید به تعریف یکپارچه مفاهیم کسبوکار، قابل ردیابی بودن منشأ اطلاعات، دسترسی کنترلشده و امکان ارزیابی کیفیت داده توجه کنند.
برای آشنایی با چارچوب گستردهتر این موضوع، به راهنمای جامع حاکمیت داده (Data Governance) مراجعه کنید. همچنین، مدیریت دادههای اصلی (MDM): از یکپارچهسازی دادههای کلیدی تا حاکمیت AI-Ready موضوع یکپارچگی موجودیتهای کلیدی سازمان را بهصورت تخصصی بررسی میکند.
۵. سازمانها از کجا شروع کنند؟
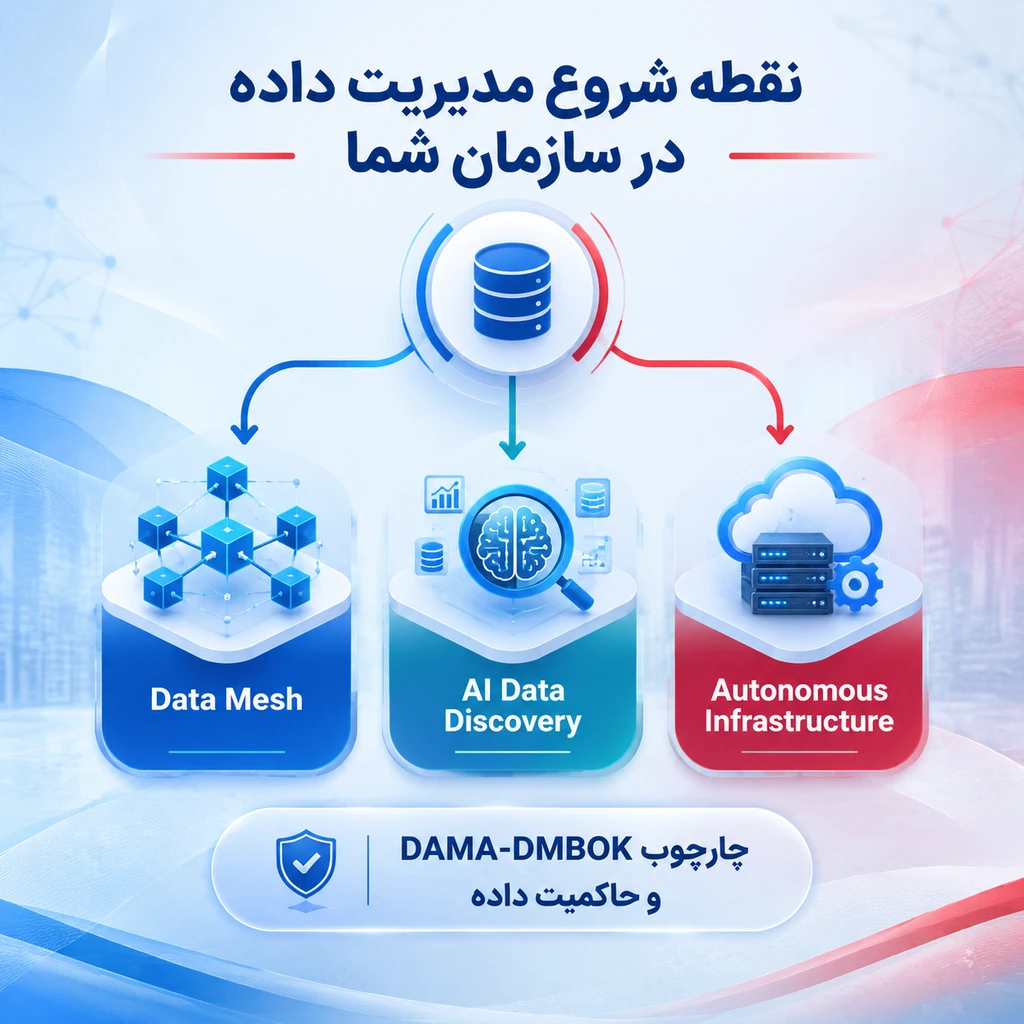
همه سازمانها به پیادهسازی همزمان این فناوریها نیاز ندارند. نقطه شروع مناسب، شناسایی مسئلهای است که بیشترین اثر را بر عملکرد و تصمیمگیری سازمان گذاشته است.
اگر دسترسی به داده به دلیل وابستگی شدید به یک تیم محدود شده، بررسی Data Mesh میتواند مفید باشد. اگر یافتن و شناخت اطلاعات دشوار است، بهبود قابلیت کشف داده و زمینه معنایی اولویت دارد. اگر بخش زیادی از ظرفیت تیم فنی صرف نگهداریهای تکراری میشود، خودکارسازی عملیات زیرساخت میتواند گزینه مناسبی باشد.
در این ارزیابی، سه پرسش کلیدی مطرح است:
آیا دادههای مورد استفاده در تصمیمهای مهم، تعریف و منبع مشخص دارند؟
آیا زیرساخت موجود توان پاسخگویی به رشد حجم داده و نیازهای تحلیلی آینده را دارد؟
آیا قابلیتهای جدید را میتوان با هزینه، ریسک و معیارهای عملکردی قابل سنجش ارزیابی کرد؟
برای تعیین مسیر اجرایی، مطالعه راهنمای گامبهگام پیادهسازی چارچوب DAMA-DMBOK در سازمانها مفید است. سازمانهایی که با دادههای مکانی و عملیاتی در مقیاس بالا کار میکنند نیز میتوانند از مطالب حاکمیت دادههای مکانی و ناوگان استفاده کنند. برای بررسی الزامات ویژه تراکنشها و کنترلهای مالی، مقاله حاکمیت داده در صنعت بانکی مرجع تخصصی این مجموعه است.
پرسشهای متداول درباره آینده مدیریت داده
آیا Data Mesh جایگزین انبار داده میشود؟
خیر. Data Mesh رویکردی برای سازماندهی مالکیت و ارائه داده است؛ انبار داده یکی از زیرساختهایی است که میتواند در این معماری به کار گرفته شود. انتخاب آنها به نیازهای سازمان و طراحی فنی بستگی دارد.
کاتالوگ داده هوشمند چه تفاوتی با کاتالوگ سنتی دارد؟
کاتالوگ سنتی بیشتر بر ثبت و جستوجوی داراییهای دادهای تمرکز دارد؛ کاتالوگ مجهز به هوش مصنوعی میتواند در کشف روابط، ایجاد زمینه معنایی و پیشنهادهای هوشمند نیز نقش داشته باشد. میزان این قابلیتها به محصول و کیفیت فراداده وابسته است.
آیا انبار داده خودران به متخصص پایگاه داده نیاز ندارد؟
خیر. خودکارسازی برخی وظایف، نیاز به طراحی معماری، نظارت، مدیریت هزینه، بررسی رخدادها و تصمیمگیری تخصصی را از بین نمیبرد؛ بلکه بخشی از فعالیتهای تکراری را کاهش میدهد.
جمعبندی
آینده مدیریت داده به سمت زیرساختهایی میرود که داده را آسانتر در دسترس قرار میدهند، زمینه معنایی آن را بهتر حفظ میکنند و بخشی از عملیات را خودکار میسازند. Data Mesh، کاتالوگهای هوشمند و انبارهای داده خودران هرکدام بخشی از این تحول را پوشش میدهند؛ اما انتخاب آنها باید بر اساس نیاز واقعی سازمان، بلوغ زیرساخت و معیارهای قابل سنجش انجام شود.
فناوری بهتنهایی مزیت رقابتی ایجاد نمیکند؛ ارزش واقعی زمانی شکل میگیرد که معماری داده بتواند تصمیمگیری سازمان را دقیقتر، سریعتر و قابل اعتمادتر کند.