معماری انبار داده سازمانی (EDW): از Staging تا Semantic Layer
انبار داده سازمانی معمولاً نه از یک جدول بزرگ، بلکه از چند لایه با مسئولیتهای روشن تشکیل میشود. ضعف لایه میتواند سرعت گزارشگیری را کم و اعداد را ناسازگار کند و میان تیمها درباره «تعریف درآمد» یا «مشتری فعال» اختلاف بیندازد. این مقاله ساختار لایهای EDW را بررسی میکند؛ نه تعریف ETL و انبار داده و نه مقایسه ETL و ELT .
چرا معماری لایهای؟
تفکیک لایهها سه مسئله را حل میکند: منبع داده را از مصرفکننده جدا میسازد، هزینه تغییرات را کاهش میدهد و ردیابی خطا را آسانتر میکند. اگر سامانه مبدأ تغییر کند، اصلاحات به لایه ورودی محدود میماند و گزارشهای مدیریتی بدون تغییر باقی میمانند. TDWI در تحلیل سال ۲۰۲۶ خود یادآور میشود که بحث Kimball در برابر Inmon همچنان اهمیت دارد؛ زیرا پرسش اصلی تغییری نکرده است: دادهها را از ابتدا در مدلی یکپارچه و سازمانی سامان دهیم یا از نیازهای کسبوکار آغاز کنیم و Data Mart بسازیم؟
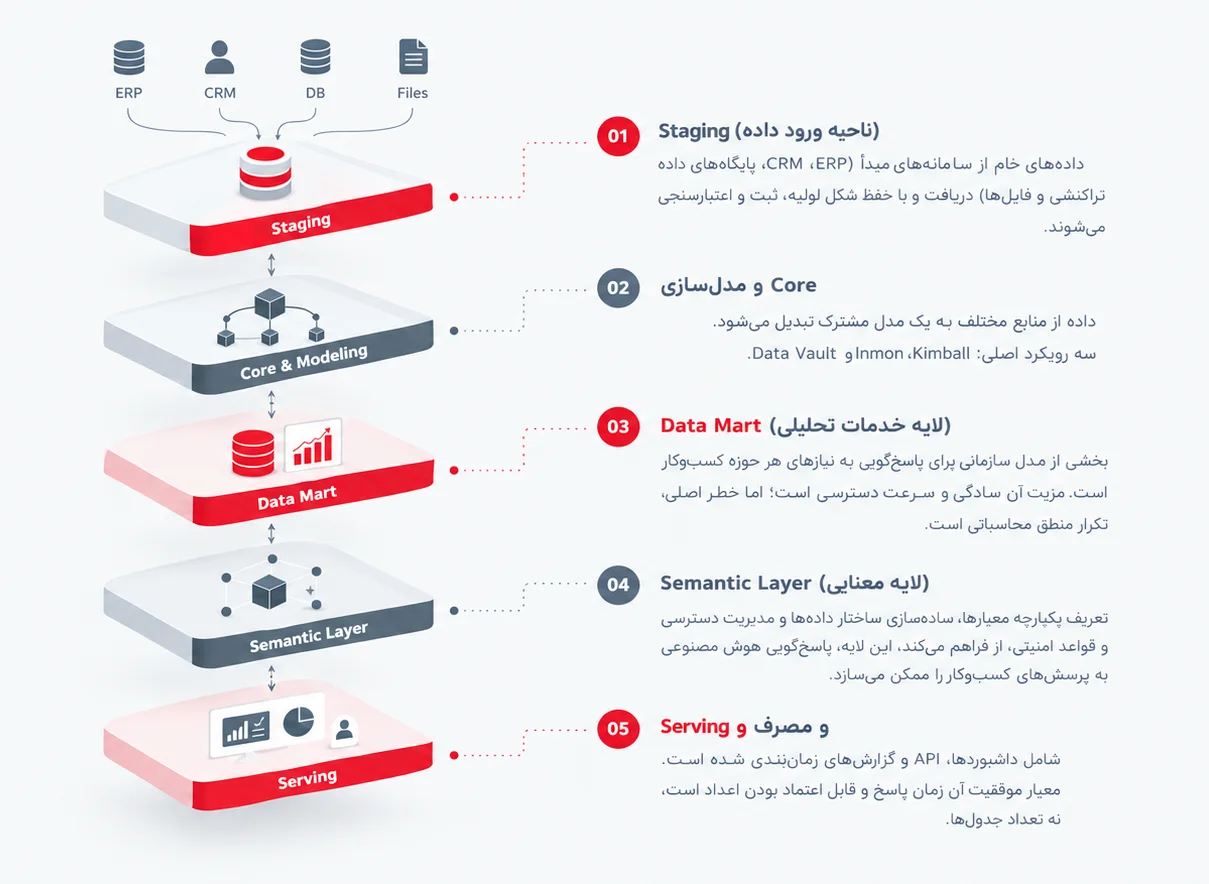
لایه اول: Staging (ناحیه ورود داده)
لایه آمادهسازی (Staging)، محل ورود دادههای خام از سامانههای مبدأ است؛ از جمله سامانههای برنامهریزی منابع سازمان (ERP)، مدیریت ارتباط با مشتری (CRM)، پایگاههای داده تراکنشی و فایلها. هدف این لایه، حفظ دادهها به همان شکلی است که دریافت شدهاند تا در صورت بروز خطا، فرایند بارگذاری دوباره اجرا شود.
سه اصل در این لایه اهمیت دارد:
حفظ داده خام: دادهها تغییر نکنند، حتی اگر ناقص یا غیرعادی باشند.
ثبت زمان دریافت: زمان بارگذاری یا نسخه منبع برای هر رکورد ثبت شود.
کنترل صحت انتقال: تعداد رکوردها و مجموع مبالغ با مقادیر سامانه مبدأ تطبیق داده شود.
در معماریهای امروزی دریاچهانبار (Lakehouse)، بسیاری از این وظایف در لایه برنزی (Bronze) انجام میشوند؛ هرچند نامگذاری و پیادهسازی ممکن است متفاوت باشد. مستندات Databricks درباره معماری مدالیون (Medallion) نیز همین تفکیک لایهای را توضیح میدهد.
لایه دوم: Core و مدلسازی
در این لایه داده از منابع مختلف به یک مدل مشترک تبدیل میشود. سه رویکرد اصلی وجود دارد:
|
رویکرد |
ایده اصلی |
مناسب برای |
ریسک اصلی |
|
Kimball |
Star Schema و Data Mart از فرایندهای کسبوکار |
تیمهایی که خروجی سریع میخواهند |
Data Martهای ناهماهنگ |
|
Inmon |
مدل نرمالشده سازمانی، سپس Mart |
سازمانهای بزرگ با قوانین سختگیرانه |
زمان و هزینه اولیه بالا |
|
Data Vault |
Hub، Link و Satellite برای ردیابی تاریخچه |
منابع متعدد و تغییر زیاد |
پیچیدگی مدل و نیاز به ابزار خودکار |
تصمیم درست به سه چیز بستگی دارد: تعداد منابع، میزان تغییر آنها و نیاز به ممیزی. سازمانی که فقط دو سیستم دارد و گزارشهای مالی ساده میخواهد، معمولاً با Kimball بهتر کار میکند. سازمانی که دهها منبع دارد و باید تاریخچه کامل تغییرات را نگه دارد، Data Vault را جدیتر بررسی میکند.
لایه سوم: Data Mart (لایه خدمات تحلیلی)
بازار داده (Data Mart) بخشی از مدل سازمانی است که برای پاسخگویی به نیازهای یک حوزه کسبوکار، مانند فروش، مالی، عملیات یا منابع انسانی، طراحی میشود. مزیت آن سادگی و سرعت دسترسی است؛ اما خطر اصلی، تکرار منطق محاسباتی است. اگر واحد فروش و مالی هرکدام درآمد را به روش خود محاسبه کنند، دو عدد متفاوت به دست میآید.
راهکار این مشکل در لایه بعدی قرار دارد.
لایه چهارم: Semantic Layer (لایه معنایی)
لایه معنایی (Semantic Layer) میان انبار داده و ابزارهای گزارشگیری قرار میگیرد و تعریف مشترکی از معیارهای کسبوکار ارائه میدهد. AtScale این لایه را واسطی میداند که مفاهیم و معانی کسبوکاری دادهها را از جزئیات فنی آنها جدا میکند.
در عمل، این لایه سه وظیفه اصلی دارد:
تعریف یکپارچه معیارها: مانند درآمد خالص، نرخ ریزش و مشتری فعال.
سادهسازی ساختار دادهها: کاربران کسبوکار برای استخراج گزارشها نیازی به نوشتن عبارتهای پیوند جدولها (JOIN) ندارند.
مدیریت دسترسی و قواعد امنیتی: یک پرسوجو ممکن است بسته به سطح دسترسی کاربر، نتایج متفاوتی برگرداند.
اهمیت این لایه در سال ۲۰۲۶ بیشتر شده است؛ زیرا پاسخگویی هوش مصنوعی به پرسشهای کسبوکار، به تعریف دقیق و یکپارچه معیارها وابسته است. اگر معیارهای سازمان معنای مشخصی نداشته باشند، مدل زبانی نیز ناچار به حدس زدن میشود. به همین دلیل، لایه معنایی در معماریهای نوین انبار داده سازمانی (EDW)، نقشی کلیدی در ارائه پاسخهای قابل اتکا دارد.
لایه پنجم: Serving و مصرف
این لایه شامل داشبوردها، API و گزارشهای زمانبندیشده است. معیار موفقیت آن زمان پاسخ و قابل اعتماد بودن اعداد است، نه تعداد جدولها.
اشتباهات رایج در پیادهسازی
ترتیب پیشنهادی ساخت برای سازمانهای ایرانی
برای سازمانهایی با سامانههای قدیمی (Legacy)، مانند نسخههای قدیمی اوراکل، و منابع داده پراکنده، معمولاً اجرای مراحل زیر کمریسکتر است:
فهرستبرداری از منابع داده و تعیین مالک هر منبع
ایجاد لایه آمادهسازی (Staging) با حفظ داده خام و کنترل تعداد رکوردها
تعریف ۱۰ تا ۱۵ معیار کلیدی با مشارکت و تأیید مالک کسبوکار
ایجاد یک مارت داده (Data Mart) برای پرکاربردترین حوزه کسبوکار
پیادهسازی لایه معنایی (Semantic Layer) برای همان معیارها
گسترش تدریجی معماری به سایر حوزهها
این رویکرد مانع از آن میشود که سازمان از همان ابتدا به ساخت یک انبار داده کامل در مقیاس گسترده روی بیاورد؛ اقدامی که معمولاً زمان اجرا و هزینه پروژه را افزایش میدهد.
سؤالهای متداول
لایه Staging دقیقاً چیست؟
Staging ناحیه موقت ورود داده خام از منابع است. هدف آن نگهداری داده بدون تغییر، امکان بازپخش بار و کنترل کیفیت اولیه است.
Kimball یا Inmon، کدام بهتر است؟
هیچکدام همیشه بهتر نیست. Kimball برای خروجی سریع و Data Markهای مشخص مناسبتر است؛ Inmon برای یکپارچگی سازمانی سختگیرانه. انتخاب به تعداد منابع، بودجه و نیاز به ممیزی بستگی دارد.
Semantic Layer چه فایدهای دارد؟
تعریف واحد معیارها را در یک جا نگه میدارد، از اختلاف عددها بین تیمها جلوگیری میکند و پاسخ ابزارهای تحلیلی و هوش مصنوعی را قابل اعتمادتر میکند.
آیا برای سازمان کوچک هم لازم است؟
همه لایهها لازم نیستند، اما جداسازی Staging از مدل نهایی و تعریف معیارها حتی در سازمان کوچک هم ارزش دارد