انبار داده سازمانی (Enterprise Data Warehouse) زیرساختی تحلیلی است که اطلاعات پراکنده در سامانههای مختلف سازمان را در بستری یکپارچه و ساختیافته گرد هم میآورد. هدف از ایجاد انبار داده، صرفاً ذخیره حجم زیادی از اطلاعات نیست؛ بلکه فراهمکردن بستری قابلاعتماد برای تحلیل عملکرد، بررسی روندها، محاسبه شاخصهای مدیریتی و پشتیبانی از تصمیمگیری سازمانی است.
برای ساخت یک انبار داده کارآمد، باید منابع اطلاعاتی به یکدیگر متصل شوند، دادهها انتقال و آمادهسازی شوند و در ساختاری مناسب برای تحلیل قرار گیرند. در این مسیر، روشهایی مانند ETL و ELT، معماریهایی مانند Data Lake و Lakehouse و فناوریهای جدید پردازش داده نقش دارند. در این راهنما، از مفاهیم پایه انتقال داده تا معماری انبار داده مدرن و روندهای مؤثر بر توسعه آن را بررسی میکنیم.
اگر تمرکز شما بر روشهای تحلیل و تصمیمگیری مبتنی بر داده است، راهنمای تحلیل داده در سازمانها مکمل این مقاله است؛ در اینجا موضوع اصلی، زیرساختی است که داده را برای تحلیل سازمانی آماده میکند.
انبار داده سازمانی چه مسئلهای را در سازمان حل میکند؟
در بسیاری از سازمانها، اطلاعات در سامانههای مختلفی مانند CRM، ERP، نرمافزارهای مالی، پایگاههای داده عملیاتی، فایلهای اکسل و سامانههای تخصصی نگهداری میشود. هرکدام از این منابع بخشی از فعالیت سازمان را ثبت میکنند؛ اما تحلیل همزمان آنها بدون یک ساختار مشترک دشوار است.
پایگاههای داده عملیاتی عمدتاً برای ثبت و پردازش تراکنشهای روزمره طراحی شدهاند، درحالیکه انبار داده برای بررسی تاریخی اطلاعات، تحلیل روندها و ترکیب دادههای چند سامانه به کار میرود. به کمک انبار داده سازمانی، میتوان اطلاعات فروش، مالی، منابع انسانی و عملیات را در یک بستر تحلیلی مشترک بررسی کرد.
چالشهایی که در طراحی انبار داده باید مدیریت شوند:
در نتیجه، کیفیت انبار داده تنها به فناوری ذخیرهسازی وابسته نیست؛ فرایندهای دریافت، آمادهسازی و کنترل اطلاعات نیز نقش تعیینکنندهای دارند.
ETL؛ آمادهسازی داده پیش از ورود به انبار داده
ETL (Extract, Transform, Load) یکی از الگوهای کلاسیک انتقال و آمادهسازی داده برای انبار داده است. در این روش، اطلاعات از منابع عملیاتی استخراج میشوند، در یک محیط پردازشی میانی پاکسازی و تبدیل میشوند و سپس در جداول و ساختارهای انبار داده بارگذاری میشوند. این تبدیلها میتوانند شامل یکسانسازی قالب تاریخ، اصلاح مقادیر نامعتبر، حذف رکوردهای تکراری، تطبیق شناسهها و آمادهسازی اطلاعات برای تحلیل باشند.
ETL همچنان در بسیاری از پروژههای انبار داده سازمانی کاربرد دارد؛ بهویژه زمانی که اطلاعات باید پیش از ورود به محیط تحلیلی پالایش شوند، قواعد پیچیده کسبوکار روی آنها اعمال شود یا محدودیتهای امنیتی و زیرساختی اجازه انتقال داده خام به مقصد را ندهند. بنابراین، استفاده از ETL به معنای قدیمیبودن معماری انبار داده نیست؛ انتخاب آن باید بر اساس ویژگی منابع، الزامات پردازش و معماری مقصد انجام شود.
نقاط قوت
نقاط ضعف
ابزارهایی مانند Informatica PowerCenter، Microsoft SSIS و Oracle Data Integrator (ODI) سالهاست که در سازمانهای بزرگ ایرانی برای ETL بکار گرفته میشوند. ODI بهویژه در بستر Oracle ۲۱c با قابلیت Knowledge Modules و اجرای ELT-native نقاط قوت متمایزی دارد.
ELT؛ تبدیل داده در محیط انبار داده مدرن
در الگوی ELT (Extract, Load, Transform)، ابتدا دادهها از منابع مختلف استخراج و بدون انجام تغییرات اساسی، مستقیماً در انبار داده مدرن بارگذاری میشوند. سپس، عملیات تبدیل و آمادهسازی دادهها، مانند پاکسازی، یکپارچهسازی و تغییر ساختار آنها، در داخل انبار داده انجام میشود. در این روش، بهجای استفاده از یک ابزار جداگانه برای پردازش دادهها پیش از بارگذاری، از توان پردازشی خود انبار داده یا موتور پردازش موازی (MPP) برای اجرای عملیات تبدیل استفاده میشود. این رویکرد به انبارهای داده مدرن امکان میدهد حجم زیادی از دادهها را با انعطافپذیری بیشتری پردازش کنند و دادههای موردنیاز برای تحلیل و گزارشگیری را آماده سازند.
چرا ELT در معماری انبار داده مدرن گسترش یافت؟
سه تحول زیربنایی این تغییر الگو را امکانپذیر کرد:
مقایسه ETL و ELT در فرایند تغذیه انبار داده
معیار |
ETL |
ELT |
|
محل اجرای Transform |
موتور میانبرنامه |
انبار داده / موتور MPP |
|
مقیاسپذیری Transform |
محدود به سرعت موتور ETL |
موازیسازی با انبار داده |
|
نگهداری دادهی خام |
معمولاً نه |
بله |
|
مناسب برای |
منابع ضعیف، تبدیلهای پیچیده |
انبارهای دادهی مدرن، Cloud |
|
ابزار نمونه |
SSIS، ODI، Informatica |
dbt + Snowflake / BigQuery |
انبار داده سازمانی (Data Warehouse) چیست و چگونه کار میکند؟
انبار داده (Data Warehouse) محیطی تخصصی برای جمعآوری، سازماندهی و تحلیل اطلاعات کسبوکار است. برخلاف پایگاههای داده عملیاتی که برای ثبت تراکنشها و اجرای فرایندهای روزمره بهینه شدهاند، انبار داده برای پرسوجوهای تحلیلی، بررسی روندهای تاریخی، مقایسه عملکرد بخشهای مختلف و تولید گزارشهای مدیریتی طراحی میشود.
برای مثال، سامانه فروش اطلاعات سفارشها را ثبت میکند، سامانه مالی تراکنشها را نگهداری میکند و سامانه انبار وضعیت موجودی را نشان میدهد. انبار داده امکان ترکیب این اطلاعات را فراهم میکند تا سازمان بتواند عملکرد فروش، سودآوری، موجودی و سایر شاخصهای خود را در یک بستر تحلیلی بررسی کند.
در معماری انبار داده سازمانی، اطلاعات پس از دریافت از منابع مختلف، متناسب با قواعد کیفیت و نیازهای تحلیلی آمادهسازی میشوند. سپس در ساختارهایی قرار میگیرند که امکان گزارشگیری، تحلیل تاریخی و محاسبه شاخصهای مشترک را فراهم میکنند. ابزارهای هوش تجاری مانند Power BI و لایههای معنایی نیز از همین ساختار برای ارائه اطلاعات به کاربران و مدیران استفاده میکنند.
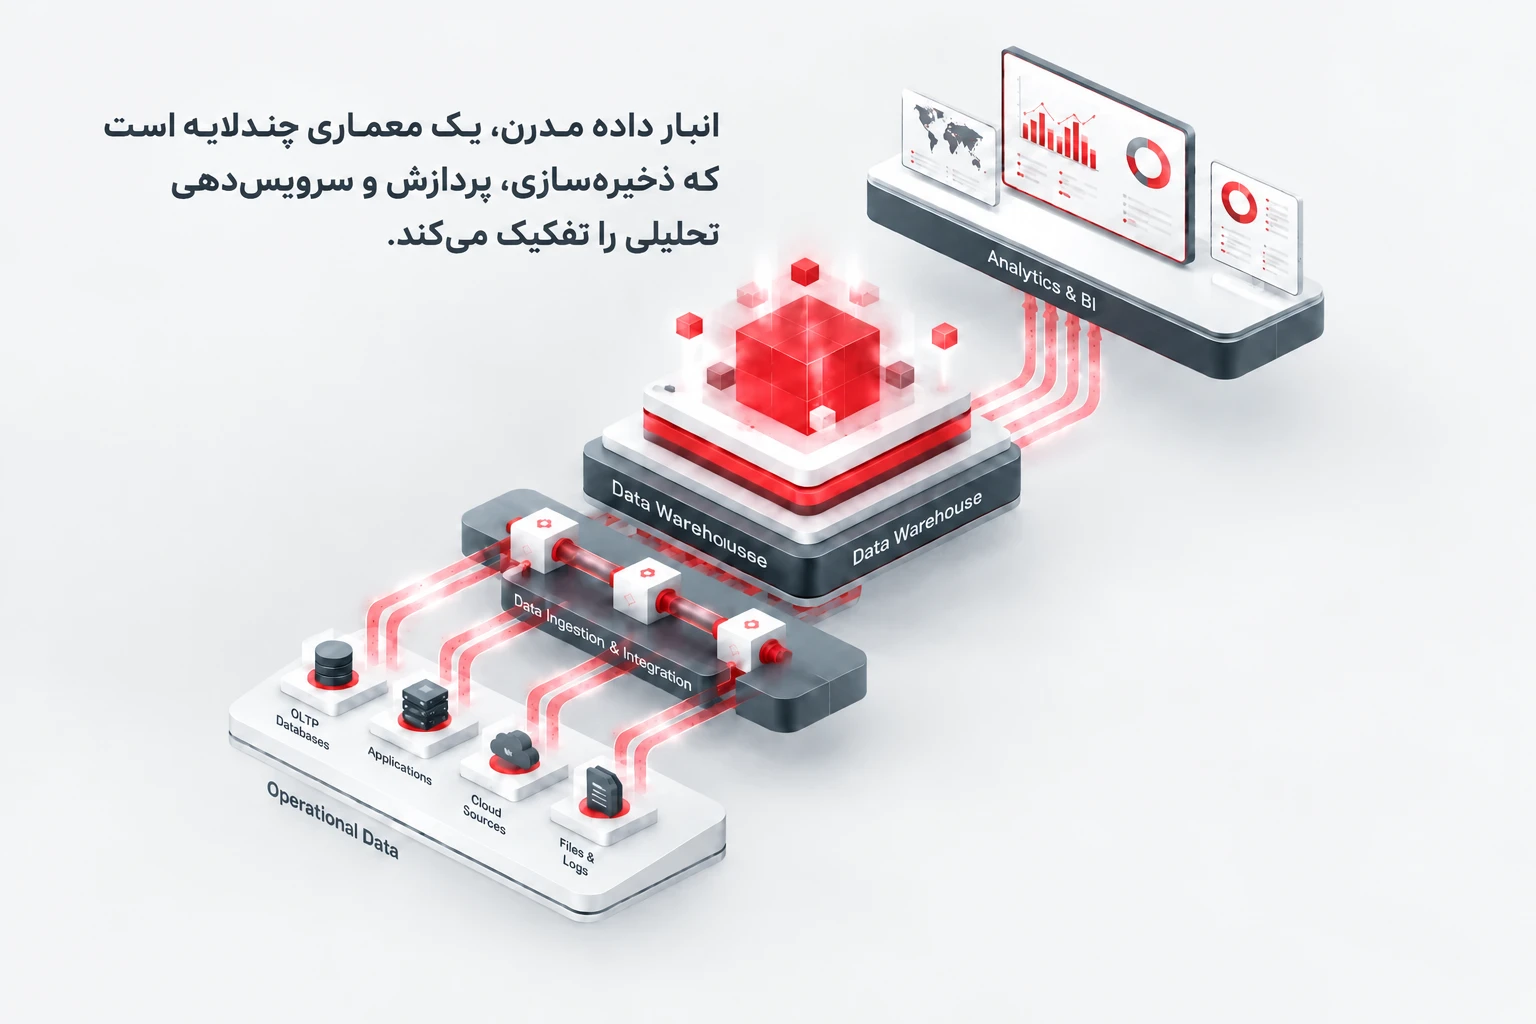
انبار داده مدرن (Modern Data Warehouse) تنها یک پایگاه دادهی بزرگ نیست؛ یک معماری چندلایه است که ذخیرهسازی، پردازش و سرویسدهی تحلیلی را تفکیک میکند.
لایههای اصلی معماری انبار داده
الگوهای رایج طراحی انبار داده سازمانی
انواع استقرار انبار داده: داخلی، ابری و ترکیبی
انبار دادههای سازمانی میتوانند بر اساس محدودیتهای فنی، امنیتی و عملیاتی سازمان، روی زیرساخت داخلی (On-Premises)، بستر ابری یا معماری ترکیبی مستقر شوند. در مدل سنتی، سازمان مسئول تأمین و نگهداری زیرساخت ذخیرهسازی و پردازش است؛ درحالیکه پلتفرمهای ابری امکان تخصیص منعطف منابع و افزایش ظرفیت را متناسب با بار کاری فراهم میکنند.
انتخاب میان این مدلها تنها به مقیاسپذیری محدود نمیشود. محل نگهداری اطلاعات، الزامات امنیتی، هزینه پردازش و انتقال، دسترسی به خدمات ابری و توان تیم فنی نیز باید در تصمیمگیری لحاظ شوند. برای برخی سازمانها، بهویژه در حوزههای بانکی و دولتی، معماری داخلی یا ترکیبی میتواند مناسبتر باشد.
همچنین بخوانید: معماری انبار داده سازمانی (EDW): از Staging تا Semantic Layer
پیش از انتخاب انبار داده، این معیارها را بررسی کنید:
برای سازمانهایی که محدودیتهای جدی در محل نگهداری اطلاعات، محرمانگی، اتصال بیرونی یا زیرساخت دارند، استفاده از ابر عمومی الزاماً بهترین انتخاب نیست. معماری محلی یا ترکیبی نیز میتواند پاسخگوی نیاز باشد؛ مشروط بر آنکه هزینه نگهداری، ظرفیت توسعه، پشتیبانگیری و مسئولیت اداره زیرساخت بهدرستی ارزیابی شود.پیش از انتخاب انبار داده، بهتر است موارد زیر را بررسی کنید:
انبار داده، Data Lake و Lakehouse؛ تفاوت نقشها در معماری داده
دریاچه داده (Data Lake) برای نگهداری حجم زیادی از داده در قالبها و درجات مختلف ساختیافتگی طراحی شده است؛ از فایلهای جدولی و گزارشها تا دادههای رویدادی، متن، تصویر و خروجی حسگرها. انعطاف در ذخیره داده از مزایای اصلی آن است، اما اگر کاتالوگ داده، کیفیت، مجوزها و مسئولیت نگهداری روشن نباشند، دریاچه داده ممکن است به مخزنی بزرگ تبدیل شود که پیدا کردن داده قابلاستفاده در آن دشوار است.
انبار داده بیشتر برای دادههای مدلشده و تحلیلهای ساختیافته به کار میرود. در مقابل، لیکهاوس (Data Lakehouse) تلاش میکند انعطاف و قالبهای باز دریاچه داده را با قابلیتهایی مانند مدیریت جدول، تراکنشپذیری، کنترل کیفیت و اجرای تحلیلهای ساختیافته ترکیب کند. این رویکرد میتواند به استفاده مشترک از زیرساخت برای هوش تجاری، مهندسی داده و یادگیری ماشین کمک کند.
Data Lake
Data Lake یک مخزن ذخیرهسازی مقیاسپذیر است که داده را بهصورت خام و با فرمت بومی (Parquet، ORC، JSON، CSV) نگهداری میکند. دادهی ساختاریافته، نیمهساختاریافته و غیرساختاریافته بدون نیاز به تعریف شماتیک اولیه ذخیره میشود.
چالش اصلی Data Lakeهای نسل اول، سوامپ شدن (Data Swamp) بود: بدون لایهی متادیتا و کاتالوگ مناسب، دادهها قابل کشف و قابل اعتماد نبودند
Lakehouse
لیکهاوس میتواند تکرار برخی نسخههای داده و پیچیدگی جابهجایی میان مخازن را کاهش دهد، اما الزاماً همه کپیها را حذف نمیکند. همچنین دسترسی مستقیم به داده خام برای هر ابزار یا مدل هوش مصنوعی همیشه مطلوب نیست؛ کنترل مجوزها، کیفیت، معنا و نسخه داده همچنان ضروری است. تصمیم معماری باید روشن کند کدام داده برای چه نوع استفادهای آماده میشود و چه کسی مسئول کیفیت و دسترسی آن است.Lakehouse معماری ترکیبی است که سه ویژگی را در یک بستر گرد هم میآورد:
فناوریهای کلیدی Lakehouse شامل فرمتهای جدولی باز مانند Apache Iceberg، Delta Lake و Apache Hudi است که ACID، Time Travel، Schema Evolution و Unified Batch/Streaming را روی ذخیرهسازی شیءمحور فراهم میکنند.
پلتفرمهایی مانند Databricks Lakehouse Platform و Snowflake (با پشتیبانی Iceberg) امروز استاندارد بازار هستند.
چالشهای طراحی و بهرهبرداری از انبار داده سازمانی
پیادهسازی انبار داده در سازمانهای بزرگ تنها به انتخاب پایگاه داده یا ابزار ETL محدود نمیشود. تعدد سامانههای عملیاتی، تفاوت ساختار اطلاعات، تغییرات مداوم منابع و نیاز به حفظ کیفیت داده، پیچیدگی طراحی و نگهداری این زیرساخت را افزایش میدهند.
تجربهی پروژههای یکپارچهسازی در سازمانهای بزرگ نشان میدهد چالشهای فنی تنها بخشی از ماجرا هستند:
نقش هوش مصنوعی در آمادهسازی و مدیریت داده برای انبار داده
با افزایش حجم و تنوع اطلاعات، استفاده از هوش مصنوعی در برخی مراحل آمادهسازی و مدیریت داده گسترش یافته است. ابزارهای مبتنی بر هوش مصنوعی میتوانند در شناسایی ساختار دادهها، پیشنهاد قواعد تبدیل، تشخیص دادههای نامعتبر و مستندسازی متادیتا به تیمهای مهندسی داده کمک کنند. این قابلیتها میتوانند بخشی از فرایندهای تکراری را سادهتر کنند، اما جایگزین طراحی معماری، کنترل کیفیت و نظارت تخصصی نمیشوند.
هوش مصنوعی جای مهندس داده را نمیگیرد، اما سرعت ساخت و نگهداری Pipelineها را بهطرز معناداری افزایش میدهد.
روندهای جدید در معماری و تغذیه انبار داده در سال ۲۰۲۶
یکپارچهسازی نزدیک به صفر (Zero-ETL)
اصطلاح Zero-ETL به معنی حذف کامل همه فرایندهای انتقال و آمادهسازی داده نیست. این اصطلاح بیشتر به اتصالهای بومی و خودکار اشاره دارد که بخشی از کارهای دستی ساخت و نگهداری خط لوله را کاهش میدهند. چنین اتصالهایی میتوانند راهاندازی برخی سناریوها را سادهتر کنند، اما سازمان هنوز باید کیفیت داده، سطح دسترسی، تازگی اطلاعات، هزینه و اثر اتصال بر سامانه مبدأ را مدیریت کند.
کمک هوش مصنوعی به مهندسی داده
ابزارهای مجهز به هوش مصنوعی میتوانند در پیشنهاد نگاشت فیلدها، تولید اولیه قواعد تبدیل، مستندسازی پایپلاین و تشخیص الگوهای غیرعادی کمک کنند. این قابلیتها بخشی از کارهای تکراری را کم میکنند، اما پیشنهاد تولیدشده باید آزمون و بازبینی شود. خطایی کوچک در تبدیل داده مالی، منابع انسانی یا اطلاعات مشتری ممکن است به گزارش نادرست یا دسترسی ناخواسته منجر شود؛ بنابراین مسئولیت طراحی، آزمون و تأیید همچنان بر عهده تیم و مالک داده است.
پردازش رویدادمحور و جریان داده
در بعضی کاربردها، اطلاعات باید در فاصله کوتاهی پس از رخداد بهروز شود؛ برای نمونه، پایش تراکنشهای مشکوک، وضعیت حملونقل یا تغییرات موجودی. معماری رویدادمحور و پردازش جریانی برای چنین نیازهایی مناسباند. اما همه شاخصهای مدیریتی به پردازش لحظهای نیاز ندارند. بارگذاری ساعتی یا روزانه برای بسیاری از گزارشها کفایت میکند و ممکن است سادهتر و کمهزینهتر باشد.
Reverse ETL و استفاده عملیاتی از تحلیل
در جریان معمول داده، اطلاعات از سامانههای عملیاتی به محیط تحلیلی منتقل میشوند. Reverse ETL بخشی از داده پردازششده را دوباره به سامانههای عملیاتی مانند CRM یا ابزارهای پشتیبانی بازمیگرداند. برای مثال، امتیاز ریسک یا دستهبندی مشتری میتواند در اختیار کارشناس قرار گیرد تا در فرایند کاری از آن استفاده کند. این کار زمانی ارزشمند است که داده بازگشتی بهروز و معتبر باشد و مجوزهای دسترسی، ثبت تغییرات و محدودیت استفاده از اطلاعات رعایت شوند.
جمعبندی
انبار داده سازمانی یکی از اجزای مهم زیرساخت تحلیلی سازمان است که امکان جمعآوری، سازماندهی و تحلیل اطلاعات پراکنده در سامانههای مختلف را فراهم میکند. در این معماری، روشهایی مانند ETL و ELT برای انتقال و آمادهسازی اطلاعات به کار میروند؛ درحالیکه انبار داده، Data Lake و Lakehouse هرکدام نقش متفاوتی در نگهداری و پردازش داده دارند.
انتخاب معماری مناسب انبار داده باید بر اساس نیازهای تحلیلی سازمان، کیفیت و حجم اطلاعات، نوع منابع، الزامات امنیتی، هزینه کل مالکیت و توان فنی تیم انجام شود. بهجای انتخاب فناوری صرفاً بر اساس جدیدبودن آن، بهتر است سازمان ابتدا نیازهای خود را مشخص کند و سپس معماری و ابزارهای مناسب را بهصورت مرحلهای توسعه دهد.
پرسشهای پرتکرار
انبار داده سازمانی چیست؟
انبار داده سازمانی محیطی متمرکز برای جمعآوری، سازماندهی و تحلیل اطلاعات از منابع مختلف سازمان است که با هدف پشتیبانی از گزارشگیری، تحلیل تاریخی و تصمیمگیری مدیریتی طراحی میشود.
تفاوت انبار داده با پایگاه داده عملیاتی چیست؟
پایگاه داده عملیاتی برای ثبت و مدیریت تراکنشهای روزمره بهینه شده است؛ در مقابل، انبار داده برای تحلیل اطلاعات، بررسی روندهای تاریخی و تهیه گزارشهای چندبعدی استفاده میشود.
آیا هر سازمانی به انبار داده نیاز دارد؟
لزوم ایجاد انبار داده به تعداد منابع اطلاعاتی، حجم داده، پیچیدگی گزارشگیری و نیازهای تحلیلی بستگی دارد. سازمانهایی که به تحلیل همزمان اطلاعات چند سامانه و گزارشهای مدیریتی یکپارچه نیاز دارند، بیشتر به چنین زیرساختی نیاز پیدا میکنند.
ETL و ELT چه تفاوتی دارند؟ در ETL، داده پیش از ورود به مقصد تبدیل میشود؛ در ELT، ابتدا داده بارگذاری و سپس در محیط مقصد تبدیل میشود. انتخاب میان آنها به الزامات امنیتی، زیرساخت و نوع بار کاری وابسته است.
آیا ELT همیشه از ETL بهتر است؟ خیر. ELT برای بسیاری از محیطهای تحلیلی مقیاسپذیر مناسب است، اما ETL زمانی مفید است که پالایش یا تبدیل پیش از بارگذاری لازم باشد. ترکیب این دو نیز امکانپذیر است.
تفاوت دریاچه داده، انبار داده و لیکهاوس چیست؟ دریاچه داده برای نگهداری دادههای متنوع و انعطافپذیر است؛ انبار داده بر تحلیل ساختیافته و گزارشگیری تمرکز دارد؛ لیکهاوس میکوشد برخی قابلیتهای مدیریتی و تحلیلی انبار داده را با انعطاف دریاچه ترکیب کند.
آیا Zero-ETL نیاز به یکپارچهسازی را از بین میبرد؟ خیر. این رویکرد میتواند بخشی از ساخت و نگهداری دستی خطوط لوله را کم کند، اما کنترل کیفیت، مجوزها، امنیت، تازگی و هزینه همچنان ضروری است.
یک سازمان متوسط از کجا شروع کند؟ با انتخاب یک مسئله روشن، شناسایی منابع مرتبط و ارزیابی کیفیت داده آغاز کند؛ سپس یک پایلوت محدود با شاخص موفقیت، مسئول مشخص و سقف هزینه تعریف کند.
مهمترین معیار انتخاب پلتفرم داده چیست؟ هیچ معیار واحدی برای همه سازمانها وجود ندارد. تناسب با بار کاری، امنیت و حاکمیت، هزینه کل مالکیت، مهارت تیم، سازگاری با سامانههای موجود و امکان توسعه یا انتقال در آینده باید با هم سنجیده شوند.