از دسترسی مستقیم عاملهای هوش مصنوعی به دادههای سازمانی تا حکمرانی بلادرنگ و کنترل هزینهها؛ پنج تحول مهم نشان میدهند که معماری مدیریت داده در سال ۲۰۲۷ به چه سمتی حرکت میکند.
با ورود هوش مصنوعی عاملمحور (Agentic AI) به فرایندهای عملیاتی، مسئله سازمانها دیگر صرفاً دسترسی به داده برای تولید گزارش یا پاسخگویی به پرسشها نیست. عاملهای هوشمند قرار است وظایف چندمرحلهای را اجرا کنند؛ وظایفی که ممکن است به اطلاعات موجود در سامانههای مختلف سازمان وابسته باشند و به دادههایی دقیق، بهروز و قابلاعتماد نیاز داشته باشند.
این تغییر، الزامات تازهای برای زیرساختهای داده ایجاد میکند. معماریهای متمرکز، مدلهای سنتی یکپارچهسازی، روشهای کنترل کیفیت و حتی شیوه محاسبه هزینه زیرساخت باید با نیازهای جدید سازگار شوند.
گزارش TechTarget که در ۱۳ نوامبر ۲۰۲۶ منتشر شده، پنج روند مهم مدیریت داده و تحلیل سازمانی را برای سال ۲۰۲۷ برجسته میکند. وجه مشترک این تحولات، حرکت از مدیریت واکنشی داده بهسوی معماریهایی است که دسترسی، معنا، کیفیت، امنیت و هزینه داده را از همان ابتدا در نظر میگیرند.
۱. دسترسی عاملهای هوش مصنوعی به دادهها در محل نگهداری آنها
در معماریهای سنتی، دادههای پراکنده سازمان معمولاً از طریق فرایندهای استخراج، تبدیل و بارگذاری (ETL) به مخازن متمرکز مانند انبار داده (Data Warehouse)، دریاچه داده (Data Lake) یا Lakehouse منتقل میشوند. این رویکرد همچنان برای یکپارچهسازی اطلاعات، گزارشگیری و تحلیلهای سازمانی ضروری است؛ اما برای تمام سناریوهای جدید هوش مصنوعی، تنها گزینه ممکن نیست.
عاملهای هوش مصنوعی برای اجرای یک فرایند عملیاتی ممکن است به اطلاعاتی نیاز داشته باشند که در چندین سامانه مستقل نگهداری میشوند؛ از CRM و ERP گرفته تا پایگاههای داده و نرمافزارهای سازمانی مبتنی بر ابر. ایجاد یک مسیر انتقال جداگانه برای هر کاربرد هوش مصنوعی میتواند زمان توسعه را افزایش دهد، هزینههای یکپارچهسازی را بالا ببرد و نسخههای تکراری از دادههای حساس ایجاد کند.
به همین دلیل، معماریهای جدید بهسمت فراهمکردن دسترسی کنترلشده عاملها به دادهها در همان محل تولید و نگهداری آنها حرکت میکنند.
این تغییر به معنای حذف انبار داده یا کنارگذاشتن فرایندهای ETL نیست. معماری آینده احتمالاً ترکیبی از مخازن داده متمرکز، جریانهای یکپارچهسازی و دسترسی مستقیم یا فدرال به منابع اطلاعاتی خواهد بود. انتخاب هر روش به نوع پردازش، حساسیت داده و الزامات امنیتی بستگی دارد.
چالش اصلی در این میان، صرفاً اتصال عامل به منابع اطلاعاتی نیست؛ سازمان باید اطمینان داشته باشد که عامل به داده مجاز دسترسی پیدا میکند، تعریف اطلاعات در سامانههای مختلف یکسان است و سوابق استفاده از داده قابل پیگیری باقی میماند.
۲. لایه هستیشناختی به بخش مهمتری از معماری داده تبدیل میشود
یکی از محدودیتهای استفاده از عاملهای هوش مصنوعی در سازمانها، ناآشنایی آنها با ساختار واقعی کسبوکار است. دسترسی به جدولها، گزارشها و شاخصها لزوماً به این معنا نیست که یک عامل میتواند روابط میان مفاهیم سازمانی را بهدرستی درک کند.
لایه معنایی (Semantic Layer) سالهاست برای یکسانسازی تعاریف داده و نحوه محاسبه شاخصهای کسبوکار در ابزارهای هوش تجاری به کار میرود. برای مثال، این لایه مشخص میکند درآمد چگونه محاسبه میشود، مشتری فعال چه تعریفی دارد و هر شاخص از کدام منابع اطلاعاتی استخراج میشود.
اما لایه هستیشناختی (Ontology Layer) یک گام فراتر میرود. این لایه موجودیتهای اصلی سازمان، روابط میان آنها و قواعد حاکم بر این روابط را مدلسازی میکند و آنها را به دادههای واقعی متصل میسازد.
برای مثال، یک عامل هوشمند تنها نباید بداند درآمد یک محصول چقدر است؛ بلکه باید بتواند رابطه محصول با مشتریان، قراردادها، شرایط استفاده و سایر موجودیتهای کسبوکار را نیز درک کند. چنین شناختی برای اجرای وظایف چندمرحلهای و تصمیمگیری در محیطهای پیچیده ضروری است.
اهمیت این موضوع در تحولات اخیر بازار نیز دیده میشود. Databricks در ۱۱ نوامبر ۲۰۲۶ قابلیت Genie Ontology را بهصورت عمومی عرضه کرد و Snowflake نیز در ۳ نوامبر از Business Ontology رونمایی کرد؛ قابلیتهایی که نشان میدهند مدلسازی مفاهیم و روابط سازمانی در حال تبدیلشدن به یکی از اجزای مهم زیرساخت هوش مصنوعی هستند.
در این معماری، پروتکل Model Context Protocol (MCP) نیز میتواند مسیر دسترسی عاملها به منابع و زمینه موردنیاز را فراهم کند. بااینحال، MCP جایگزین هستیشناسی نیست؛ پروتکل اتصال و تعامل است، درحالیکه هستیشناسی ساختار مفهومی و روابط کسبوکار را تعریف میکند.
۳. حکمرانی داده از ابتدای طراحی سامانهها آغاز میشود
در بسیاری از سازمانها، فعالیتهای حکمرانی داده پس از استقرار سامانهها و آشکارشدن مشکلاتی مانند ناسازگاری اطلاعات، ضعف کیفیت یا نبود مستندات کافی آغاز میشود. در چنین شرایطی، اصلاح مسائل معمولاً هزینهبر است و ممکن است به تغییر در معماری یا فرایندهای عملیاتی نیاز داشته باشد.
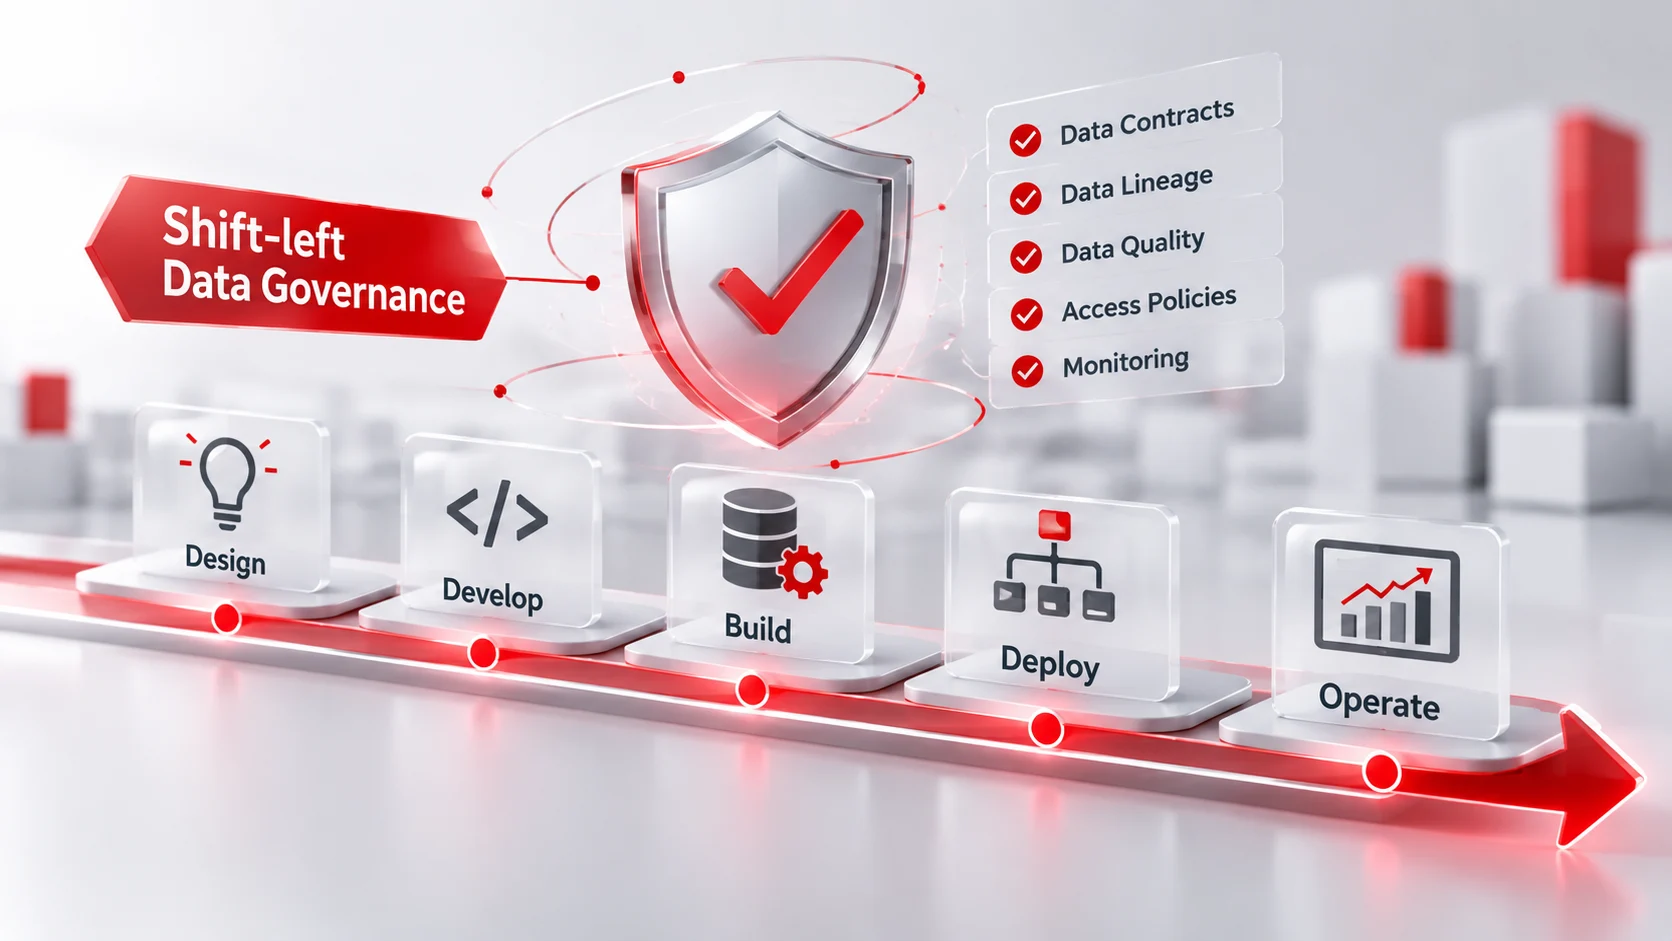
رویکرد Shift-left Data Governance تلاش میکند این مسئله را تغییر دهد. در این روش، الزامات حکمرانی داده از همان مراحل طراحی معماری، توسعه نرمافزار و ایجاد جریانهای داده در نظر گرفته میشوند؛ نه اینکه صرفاً پس از بروز مشکل به سامانه اضافه شوند.
این رویکرد میتواند شامل تعریف قراردادهای داده (Data Contracts)، مستندسازی تبار داده (Data Lineage)، پروفایلسازی و طبقهبندی خودکار اطلاعات، اعمال سیاستهای دسترسی بهصورت کد (Policy as Code) و پایش مستمر کیفیت داده باشد.
برای نمونه، هنگام طراحی یک جریان انتقال اطلاعات، میتوان از ابتدا مشخص کرد که ساختار داده چه ویژگیهایی باید داشته باشد، چه کنترلهایی برای اعتبارسنجی آن اجرا شوند و کدام واحد سازمانی مسئول کیفیت و تغییرات آن است.
البته حکمرانی پیشدستانه هنوز به رویکرد غالب در تمام سازمانها تبدیل نشده است؛ اما با افزایش استفاده عملیاتی از هوش مصنوعی، اهمیت آن بیشتر خواهد شد. هدف این روش، افزایش کنترلها به هر قیمت نیست؛ بلکه کاهش هزینه اصلاح خطاها و فراهمکردن امکان استفاده مطمئنتر از داده است.
۴. داده بلادرنگ، حکمرانی را با چالش سرعت روبهرو میکند
عاملهای هوش مصنوعی میتوانند اطلاعات را در لحظه دریافت و بر اساس آن اقدام کنند. به همین دلیل، تأخیر در بهروزرسانی داده ممکن است باعث شود عامل بر مبنای شرایطی تصمیم بگیرد که دیگر وجود ندارند.
بر اساس نظرسنجی واحد Omdia از ۳۸۵ متخصص فناوری اطلاعات و داده که نتایج آن در اکتبر ۲۰۲۶ منتشر شد، نیمی از پاسخدهندگان اعلام کردهاند که جریان داده بلادرنگ (Real-time Streaming) رایجترین روش سازمانشان برای تأمین داده ابزارهای هوش مصنوعی است. این سهم برای پردازشهای دستهای زمانبندیشده (Batch Processing) به ۳۸ درصد میرسد.
اما همین نظرسنجی یک شکاف مهم را نشان میدهد: تنها ۷ درصد پاسخدهندگان گفتهاند برنامههای حکمرانی داده سازمانشان برای پشتیبانی از فرایندهای خودکار و بلادرنگ طراحی شده است. نزدیک به شش نفر از هر ده نفر نیز سازگارکردن حکمرانی داده با عاملهای هوش مصنوعی را چالشی جدی یا بسیار جدی ارزیابی کردهاند.
این فاصله میان سرعت دسترسی به داده و توانایی کنترل آن، یکی از مسائل مهم معماری سازمانی در سال ۲۰۲۷ خواهد بود.
در چنین شرایطی، کنترل کیفیت باید درون جریان داده انجام شود، تبار و سوابق دسترسی قابل ثبت باشند و مجوزها متناسب با درخواست هر عامل در همان لحظه بررسی شوند. اتکا به نقشها و مجوزهای ثابت، بدون توجه به زمینه درخواست، برای تمام سناریوهای جدید کافی نخواهد بود.
البته بلادرنگبودن بهخودیخود یک مزیت نیست. سازمان باید بر اساس ماهیت فرایند مشخص کند چه اطلاعاتی واقعاً به بهروزرسانی لحظهای نیاز دارند و کدام موارد را میتوان با پردازشهای دورهای و کمهزینهتر مدیریت کرد.
۵. هزینه زیرساخت داده و هوش مصنوعی به یک مسئله معماری تبدیل میشود
با انتقال عاملهای هوش مصنوعی از مرحله آزمایش به محیط عملیاتی، ساختار هزینه استفاده از داده نیز تغییر میکند. عاملها ممکن است برای انجام یک وظیفه چندین پرسوجو اجرا کنند، به ابزارهای مختلف متصل شوند، درخواستهای خود را تکرار کنند و حجم زیادی از داده و منابع محاسباتی را مصرف کنند.
در چنین شرایطی، هزینه تنها به خرید زیرساخت یا ذخیرهسازی محدود نمیشود؛ نگهداری جریانهای داده، اجرای کوئریها، پردازشهای تکراری و مصرف توکن نیز باید در محاسبات اقتصادی لحاظ شوند.
در گزارش بنچمارک زیرساخت داده سازمانی ۲۰۲۶ شرکت Fivetran، بر اساس نظرسنجی از بیش از ۵۰۰ مدیر ارشد حوزه داده و فناوری در سازمانهای بزرگ، میانگین بودجه سالانه برنامههای داده بیش از ۲۹.۳ میلیون دلار برآورد شده است. این گزارش همچنین ۲.۲ میلیون دلار از این هزینه را به نگهداری خطوط انتقال داده اختصاص میدهد. این ارقام مربوط به جامعه آماری همان پژوهش هستند و نباید بدون توجه به اندازه سازمان و روششناسی مطالعه به تمام کسبوکارها تعمیم داده شوند.
یکی از راهکارهای کنترل این هزینهها، انتقال مدیریت اقتصادی به مراحل طراحی معماری است. پیشبینی هزینه پیش از استقرار، حذف پردازشهای تکراری، بهینهسازی پرسوجوها و اندازهگیری هزینه هر درخواست یا هر بار اجرای عامل میتوانند به شفافترشدن هزینه واقعی استفاده از هوش مصنوعی کمک کنند.
اهمیت لایه معنایی نیز در همین زمینه بیشتر میشود. Gartner پیشبینی کرده است سازمانهایی که معنا و ساختار داده را در آمادهسازی دادههای مناسب هوش مصنوعی در اولویت قرار میدهند، میتوانند دقت هوش مصنوعی عاملمحور را تا ۸۰ درصد افزایش دهند و هزینهها را تا ۶۰ درصد کاهش دهند. این ارقام پیشبینی حداکثری Gartner هستند، نه تضمینی برای کاهش هزینه در همه پروژهها.
در نتیجه، هزینه استفاده از هوش مصنوعی دیگر صرفاً موضوعی برای بررسی واحد مالی یا مدیریت زیرساخت پس از استقرار نیست؛ باید در انتخاب معماری، شیوه یکپارچهسازی و نحوه دسترسی عاملها به داده لحاظ شود.
معماری داده سازمانی برای سال ۲۰۲۷ چه تغییری میکند؟
این پنج روند را نمیتوان پروژههایی مستقل از یکدیگر در نظر گرفت. دسترسی عامل هوش مصنوعی به دادههای پراکنده بدون وجود تعاریف مشترک میتواند به برداشتهای متناقض منجر شود. لایه معنایی و هستیشناختی بدون کیفیت و تبار قابلاعتماد داده محدود میمانند و جریان بلادرنگ بدون کنترل دسترسی و پایش مستمر، ریسک عملیاتی ایجاد میکند.
از سوی دیگر، معماریای که هزینه انتقال، پردازش و استفاده از داده را از ابتدا در نظر نگیرد، ممکن است با افزایش تعداد عاملها به زیرساختی پرهزینه و دشوار برای مدیریت تبدیل شود.
بنابراین، مسئله اصلی سازمانها در سال ۲۰۲۷ صرفاً افزودن قابلیتهای هوش مصنوعی به سامانههای موجود نیست. آنها باید زیرساختی داشته باشند که داده را از منابع مختلف در دسترس قرار دهد، معنای آن را حفظ کند، استفاده از آن را تحت کنترل نگه دارد و هزینه این فرایند را قابلاندازهگیری سازد.
در چنین شرایطی، آمادگی برای هوش مصنوعی عاملمحور بیش از هر چیز به بلوغ معماری و مدیریت داده سازمان وابسته خواهد بود.
منابع:
TechTarget، ۵ Data Management and Analytics Trends to Watch for in ۲۰۲۷، ۱۳ نوامبر ۲۰۲۶.
Gartner، Top ۱۰ Strategic Technology Trends for ۲۰۲۷، ۲۰ اکتبر ۲۰۲۶.
Fivetran، The Enterprise Data Infrastructure Benchmark Report ۲۰۲۶، ۲۶ مارس ۲۰۲۶.